事情的起因是,2号下午要和群友唱k,做安排的时候又听到豚乙女的《響縁》,研究了一下发现好像唱的难度不高,于是1号下午出勤完回来之后就想做个卡拉OK字幕视频。打完轴准备导视频,忽然想起之前B站检查有没有人做过的时候,发现这歌有个PV视频,去YouTube上找了一下下了原视频下来,结果发现视频分辨率很低(虽然也不是不能看),于是就想给视频做个超分辨率处理。
我自己电脑上有下过nihui大佬的waifu2x-ncnn-vulkan,之前用来做过一些图片的超分,首先想起这个看能不能用在视频上。让deepseek研究一下之后结果是不能,再调研一下之后D老师给推荐了video2x、Waifu2x-Extension-GUI和Real-ESRGAN等。(其实首先是想到用ffmpeg放大视频分辨率,不过问了下D老师后发现ffmpeg一般只能做线性插值放大,于是再问有什么开箱即用的超分工具)
video2x确实很开箱即用,直接用的命令行版本,官方仓库release下载zip解压后直接运行就可以了。D老师给的指令其实用的就是Real-ESRGAN模型,将视频 852x480 放大 4 倍大约是 3408x1920。
video2x -i input.mp4 -o output.mp4 -p realesrgan -s 4 --realesrgan-model realesr-animevideov3这东西是直接打包好的,直接就运行起来了,很方便啊! 不过但是有个小问题……
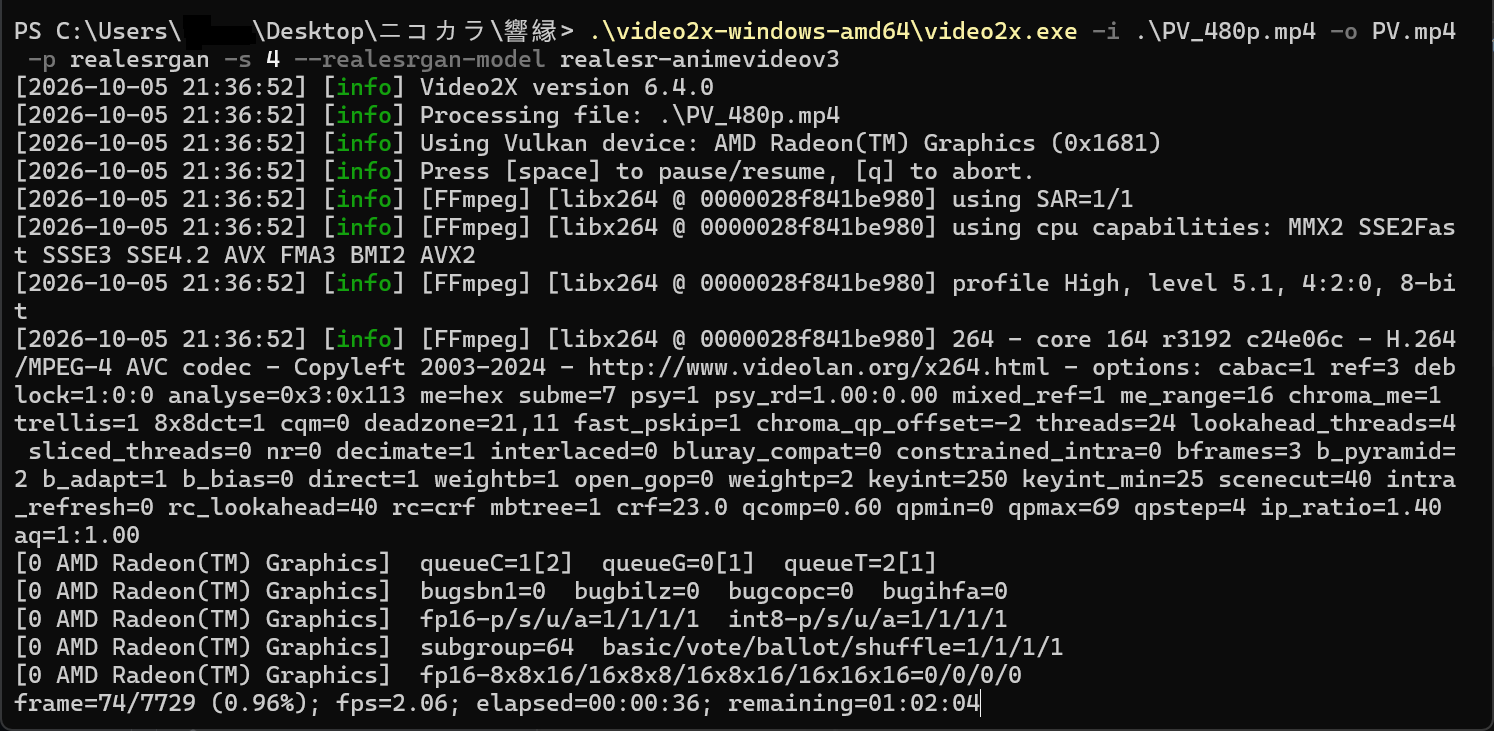
问题在于我电脑没有显卡,完整跑完要1个小时左右,而彼时已经晚上过了12点,第二天还要k一下午,这我肯定等不了啊,所以想干脆去租张卡来跑吧,应该会快一点?——AutoDL,启动!
踩坑
video2x
租的一张4090D with Pytorch 2.3.0。
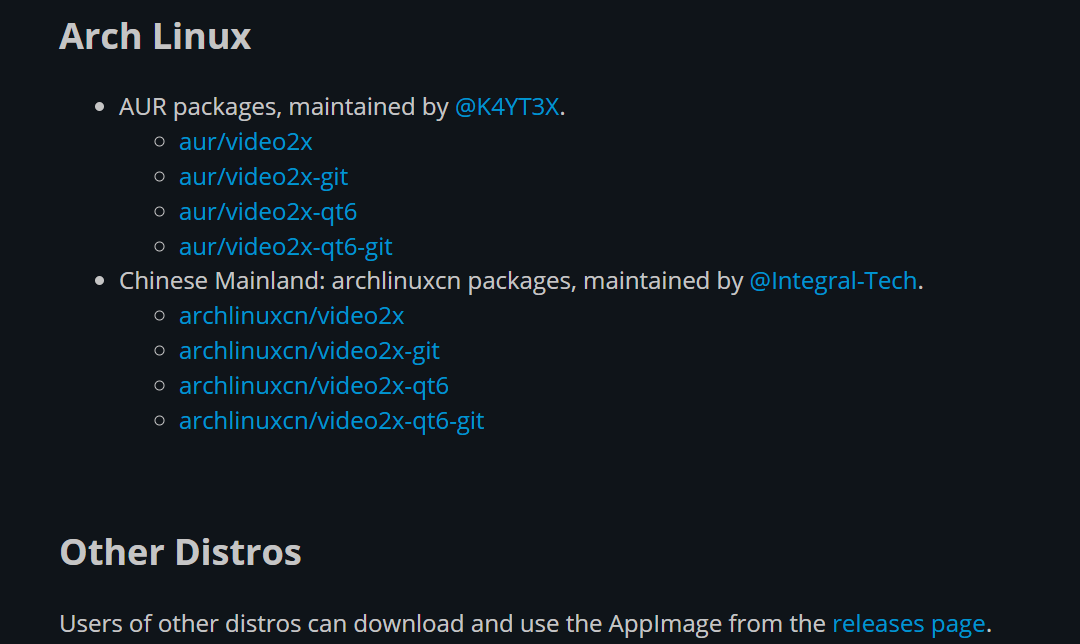
官方文档里Linux系统的安装教程,只说arch有aur包,其它系统建议使用appimage——不熟,问下D老师:
如果你不想用 Docker,AppImage 是第二选择。它是一个独立的可执行文件,在大多数现代 Linux 发行版上都能直接运行,不需要安装。
步骤: 从 Video2X Releases 页面 下载 Video2X-x86_64.AppImage 文件。 赋予执行权限并运行:
那这里马上就遇到第一个问题:报错找不到libfuse。D老师给的解法是:
- 方法一:安装 libfuse2(最简单)
- 方法二:解包运行(无需 FUSE)
简单尝试后方法一不管用,那就用方法二吧。解包确实成功运行,但是运行又遇到第二个报错:
./squashfs-root/AppRun -i PV_480p.mp4 -o PV_2k_denoise.mp4 -p realcugan -s 4 -n 2 --realcugan-model models-se./squashfs-root/AppRun: error while loading shared libraries: libvulkan.so.1: cannot open shared object file: No such file or directory这个报错说明系统里缺少 Vulkan 的加载器库(libvulkan.so.1)。Video2X 依赖 Vulkan 与 GPU 通信,所以需要先把这个库装上。
操作大概是安装Vulkan加载器,以及检查NVIDIA的驱动配置文件。紧接着又出现新的问题:
现在有两个问题需要解决:libasound.so.2 缺失是小事,关键是 Vulkan ICD 列表里没有 NVIDIA,说明容器内的 NVIDIA Vulkan 驱动没有暴露出来。我们一步步来。
vulkaninfo 显示 Devices 列表是空的,说明 ICD 虽然写了,但 libGLX_nvidia.so.0 实际加载失败了。最常见的原因是它依赖的配套 NVIDIA 库没挂载全。我们逐个排查。
后面操作大概是装东西和手动添加配置文件,最终还是调通了Vulkan,能识别到4090D了。再次尝试运行video2x,结果……又报错了,提示version 'GLIBC_2.38' not found。
你日志中 GLIBC_2.38 not found 和 GLIBCXX_3.4.32 not found 的报错,是典型的系统底层库版本过低,导致无法满足 AppImage 的运行时要求。
🔍 问题根源 你租用的 AutoDL 容器底层系统大概率是 Ubuntu 22.04,其 glibc 版本为 2.35。而 Video2X 的 AppImage 是在 Ubuntu 24.04(glibc 2.39)上打包的,它依赖的 libc.so.6 和 libstdc++.so.6 都是新版。容器内的旧版库无法提供 GLIBC_2.38 和 GLIBCXX_3.4.32 这两个符号,因此所有依赖库都加载失败。
⚠️ 为什么不建议手动升级 GLIBC 手动升级 glibc 是极高风险操作,极易导致系统命令(如 ls、apt)全部失效,甚至容器无法启动。在租用的云容器上,强烈不建议尝试这种方式。
这……?唉,服了……
D老师:反正有torch环境,直接用底层的Real-ESRGAN跑吧
你说得对,直接用Real-ESRGAN跑吧。于是就开始了新一轮的安装和配环境……
先拉取Real-ESRGAN的代码,直接git clone发现网络不行之后,source一下autodl给的加速服务脚本,然后这里懒得再开虚拟环境了,直接在全局python环境下pip install了,结果——pip提示找不到basicsr?
诶,这是个什么库啊……去查了一下,pypi源上有这个库,那我切换到pypi源试试?这回确实能下载,但是下载速度巨慢啊。(下载过程中又去阿里的pip源搜了一下,也能搜到basicsr,但是pip install还是找不到……)
好吧,等了半天之后,pip install终于报错了(憋笑)。
后面跟着d老师又来来回回折腾几次还是安装失败,最后实在有点没辙了。我还在自己电脑开个虚拟环境测了一下,阿里源pip install没问题——诶我venv建个虚拟环境试试吧。结果这回在虚拟环境下pip install就成功了,嗯?!
总之历经千辛万苦配好环境,程序终于是跑起来了(中间还修了几个小问题):
python inference_realesrgan_video.py \ -i PV_480p.mp4 \ -o PV_2k_denoise.mp4 \ -n realesr-animevideov3 \ -s 4运行脚本……怎么还是很慢……大概要50分钟跑完整个PV视频……
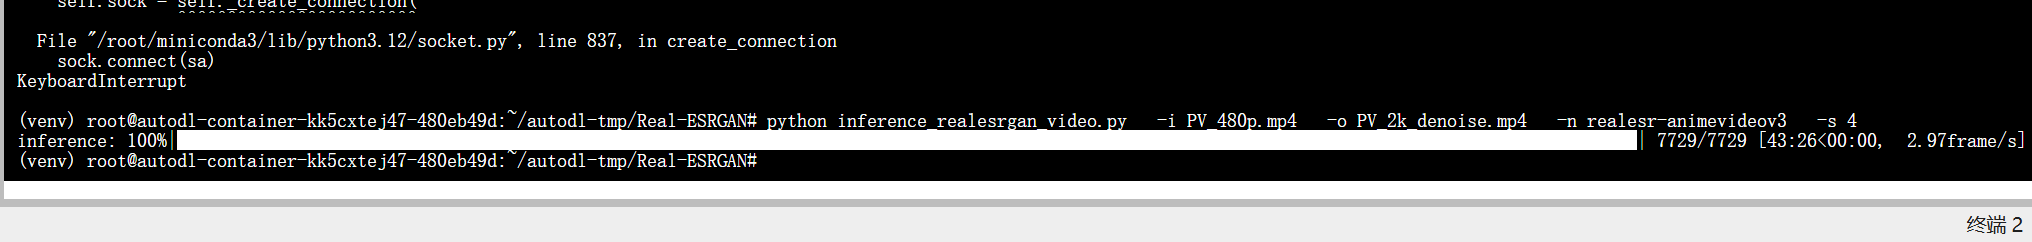
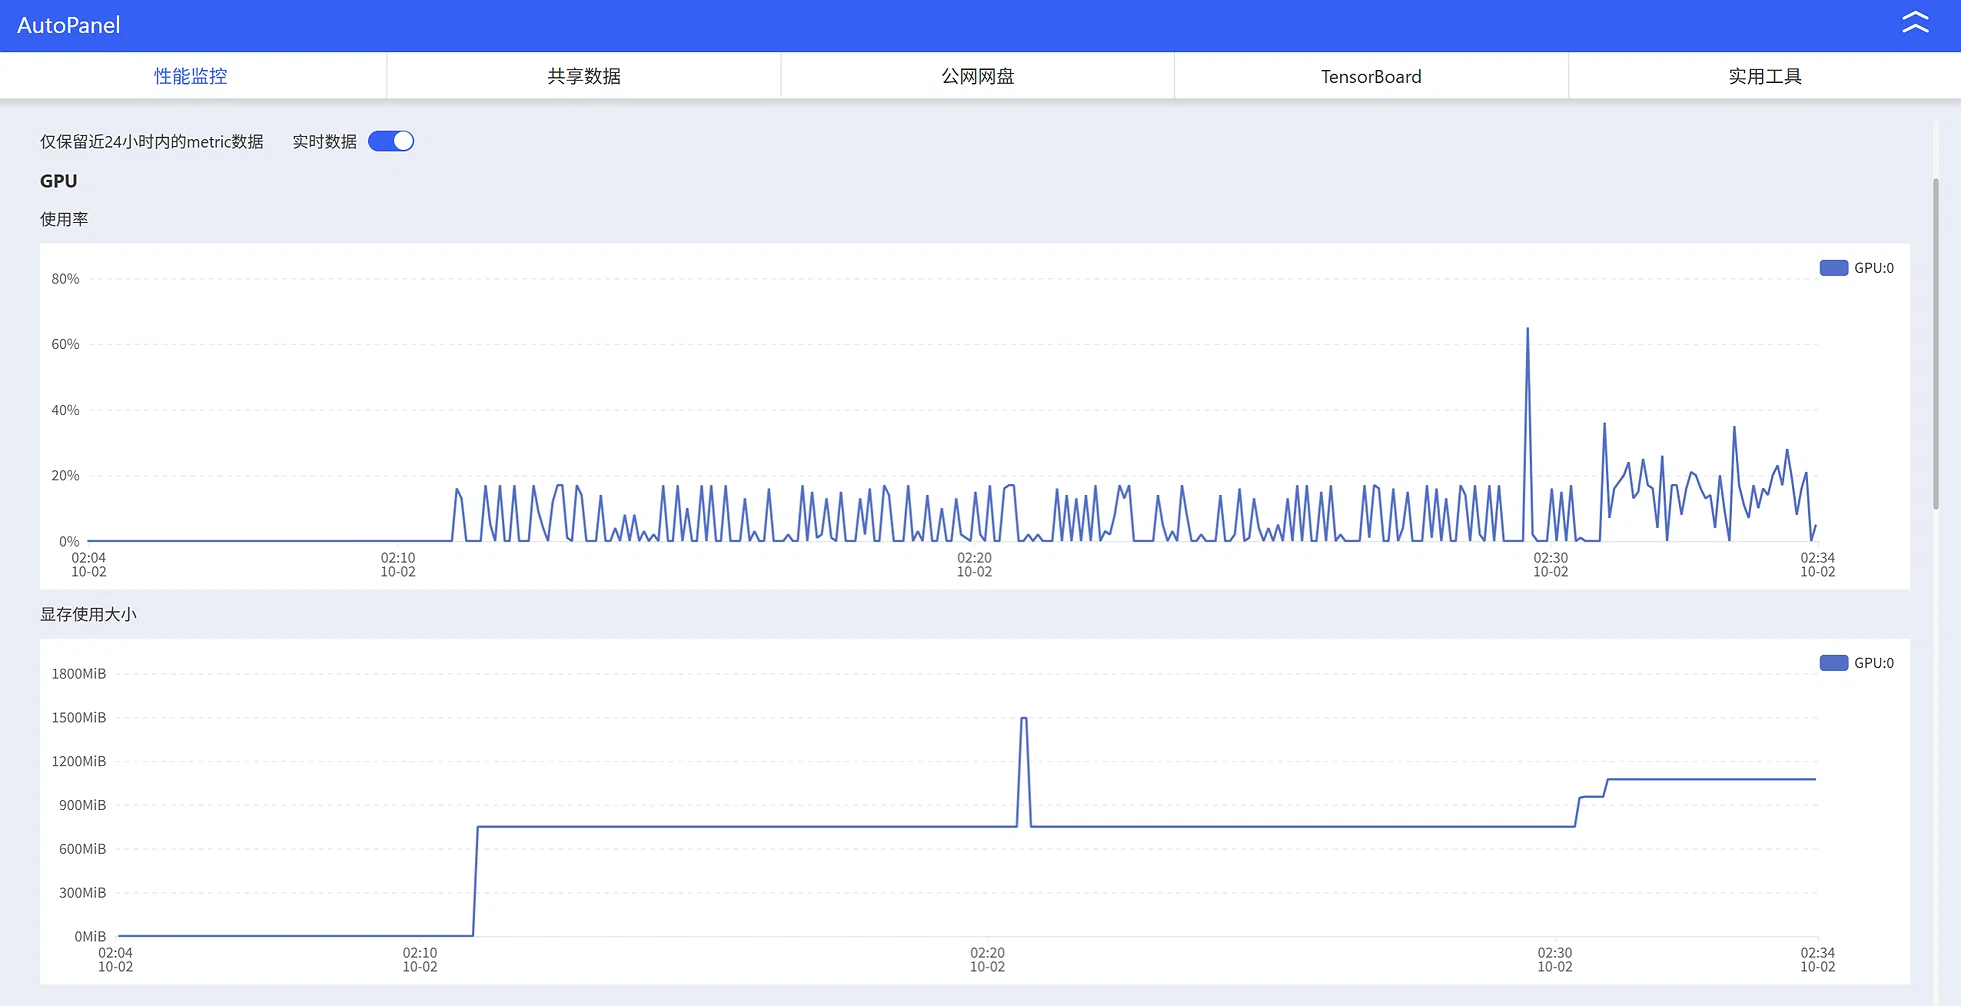
运行过程中检查GPU,显存占用很低,GPU利用率则一直是尖峰状——根据以往经验,感觉大概率是batch开小了、通信瓶颈了啥的啊?
但是这里实在懒得再去研究程序代码了(其实犯傻了,可以让D老师——或者直接丢给codex,md充了钱不用是什么弱智——帮我优化代码的,但这会已经有点麻木了),然后稍微尝试了下D老师给的些建议:
- 开fp16(没用,至少argparse没有—fp16的选项)
- —tile 0 不开启分块(貌似没用,没仔细看)
有点难绷……
D老师的其它建议
🚀 更优方案:Apptainer + Video2X(Vulkan 加速) 既然 PyTorch 路线效率不高,强烈建议试试 Apptainer 运行 Video2X 的 Docker 镜像。Apptainer 不需要 root,可以在 AutoDL 容器内运行,而且镜像内自带完整的 Vulkan 环境和 GLIBC,完全绕开你之前遇到的所有兼容性问题。
之前D老师其实建议过docker直接安装Video2x,虽然很快反应过来autodl上不支持docker,于是推荐了apptainer的方案,但当时有点懒得折腾没搞。这里先让脚本跑着,同时就装下apptainer试试,那再但是,运行发现下载镜像又要个把小时,
下载速度只有约 670 KB/s,总共约 1.8GB,预计还要 40 分钟以上。你可以让它继续在后台跑,同时我推荐一个更快的替代路径。
🚀 更快的方案:直接用 realesrgan-ncnn-vulkan 你之前已经配好了 Vulkan 环境(vulkaninfo 能识别 4090 D),而 nihui 的 realesrgan-ncnn-vulkan 是一个单文件二进制程序,体积只有几十 MB,下载快、不需要 Python 环境,可以直接利用你配好的 Vulkan。
…
2.直接对视频进行超分
这个工具本身只处理图片,需要配合 FFmpeg 拆帧和合成。但社区已经有封装好的脚本,或者你可以用一条管道命令:
…
??这你不早说?
这回基本一遍跑通了,GPU利用率也没明显尖刺,但——还是很低。跑完整个PV要多久没记,反正也要蛮长时间吧,感觉是跟稍早启动的torch的任务差不多时候跑完的。
总之最后先用torch版脚本跑了一个视频,丢给nicokaramaker了。
复盘
第三天晚上(其实应该是第二天,睡了两觉所以算第三天×)大概是脑子缓过来了,想起让gpt-5.6 sol一顿分析,gpt大人定睛一看,这Real-ESRGAN官方的脚本一堆冗余低效代码啊!
静态分析结论:4090D 并没有被模型本身压满。当前脚本是典型的“逐帧、batch=1、强制同步、CPU/GPU 来回搬运、软件编码”链路,GPU 只在单帧推理时短暂工作,因此表现为显存占用低、利用率尖刺。
程序实际工作流程
每一帧依次执行:
- FFmpeg 子进程解码视频,输出 CPU 端
bgr24原始帧。- Python 从管道阻塞读取一帧。
- NumPy/OpenCV 完成:
uint8 → float32- 除以 255
- BGR→RGB
- HWC→CHW
- PyTorch 将 FP32 帧复制到 GPU,再转换成 FP16。
realesr-animevideov3对单帧执行 4× 推理。- 输出先在 GPU 上从 FP16 转为 FP32,然后以 FP32 拷回 CPU。
- CPU 完成 clamp、通道重排、乘 255、round、转
uint8。- Python 再把输出复制成
bytes,阻塞写入 FFmpeg 管道。- FFmpeg 使用 CPU
libx264编码。- 进入下一帧。
最明显的性能问题
1. 每帧都有大量无谓的 FP32 回传和 CPU 临时数组
问题最集中的代码在 realesrgan/utils.py:193:
它把约 3416×1920 的输出转换成 FP32 后再传回 CPU。以 854×480 输入为例:
- FP32 回传约 79 MB/帧。
- 最终真正需要写给编码器的 BGR8 数据只有约 20 MB/帧。
- 乘法、round、astype 还会生成多个几十 MB 的 CPU 临时数组。
更合理的是直接在 GPU 上完成,这样 GPU→CPU 传输量理论上降低到原来的约四分之一,也减少 CPU 内存带宽压力。
2. 输出又被额外复制了两次
Writer.write_frame中:
enhance()返回值已经是uint8,这里的astype()默认仍会复制整张约 20 MB 的图,然后tobytes()再复制一次。至少可以改成:
是否能直接写
memoryview取决于当前 Python/管道实现;即使保留tobytes(),也应该删除重复的astype()。3. 软件 x264 编码阻塞了下一帧推理
输出固定使用
libx264,见 inference_realesrgan_video.py:145。 …4. 整个循环没有流水并行
虽然解码器和编码器是 FFmpeg 子进程,但 Python 主循环仍然是:
没有:
- 解码预取队列
- 多帧 batch
- pinned memory
- 异步 H2D/D2H
- CUDA stream 双缓冲
- 独立写入线程
因此 GPU 无法用下一帧工作覆盖当前帧的 CPU 后处理或编码时间。
5.
torch.cuda.synchronize()多余,但不是主因循环末尾的inference_realesrgan_video.py:272:
确实会形成同步点,但
enhance()中的.cpu()已经隐式等待 GPU,所以删除它通常只有小幅收益。真正需要消除的是同步式的 FP32.cpu()设计,而不只是这一行。
让gpt对着优化一版,连到服务器后跑一遍测一下耗时,原来50分钟的任务,优化后只要5分钟啊!
| 阶段 | 原始实现 | 优化验证 |
|---|---|---|
| 读帧 | 0.88 ms | 0.92 ms |
| CPU 预处理 | 1.55 ms | 1.90 ms |
| CPU→GPU | 1.09 ms | 1.20 ms |
| 模型推理 | 12.28 ms | 12.34 ms |
| 后处理与 GPU→CPU | 204.77 ms | 4.82 ms |
| 写入 FFmpeg | 80.76 ms | 25.84 ms |
| 合计 | 301.33 ms/帧 | 47.02 ms/帧 |
优化完这个最大瓶颈之后,按理来说应该优化libx264编码及管道写入,但我试了下发现,autodl租的4090D貌似不支持h264_nvenc,ffmpeg找不到可用设备(或者可能跟API版本有关系,没细究了)。
模型推理本身呢?其实也还是可以优化一点的,最简单的操作就是把代码中NCHW的channels first数据布局改成NHWC的channels last数据布局,然后就可以利用NVIDIA GPU的Tensor Cores对这种格式的优化。另外,profiler发现,虽然默认输入是NCHW布局,但是cuDNN在4090D上自动选择了NHWC的卷积算子,这就导致了反复、不必要的布局转换。
Channels Last (NHWC):维度顺序为 (Batch, Height, Width, Channels),即批次、高度、宽度、通道数。数据以 逐像素(pixel-per-pixel) 的形式连续存储(如 RGB 三个通道紧挨在一起)。
Channels First (NCHW):维度顺序为 (Batch, Channels, Height, Width),是 PyTorch 等框架的默认连续格式(torch.contiguous_format),同一通道的所有像素连续存储。
那再之后又想了几个优化点让gpt帮我试,但测试发现基本没太多显著改善:
- 开大batch(负优化,可能原因是——瓶颈主要在显存通信带宽和cpu编码延迟……什么什么的)
- 增设有界队列和独立写线程,让模型推理与FFmpeg帧写入异步重叠(改善不显著,大概是FFmpeg本身已在独立进程中并行编码,新增队列只能缓解短暂的管道阻塞,无法提高编码器的持续吞吐)
那就没太大必要了。考虑到原仓库最新的commit和release都得四年前了,于是我fork了原仓库,上传了第一轮优化后的代码。
One more thing:
不知你还记不记得给Real-ESRGAN配环境时,我说切换到pypi源确实能 “下载” ——但是安装失败。后面venv新建一个虚拟环境之后又没问题了。但,为什么?
其实大概率能猜到,下载失败应该是网络方面,具体来说是autodl的代理加速脚本的影响;而安装失败,报错信息以及D老师的分析已经指出是缺少Cython导致的,需要手动pip下载安装,这里使用阿里源也不行,一样要指定pypi源。那么,具体到底是什么原因呢?
还是要/拜谢gpt大人的debug水平:不是venv修复了pip,而是/etc/network_turbo设置的代理拦截了阿里云pip源,代理访问阿里云源返回403从而报错“No matching distribution”。为什么network_turbo会影响阿里云pip源?其代理策略中对aliyuncs.com设置了no_proxy,但问题是,阿里云 pip 镜像域名是mirrors.aliyun.com,因此pip请求仍会经过加速代理,并被代理返回403。
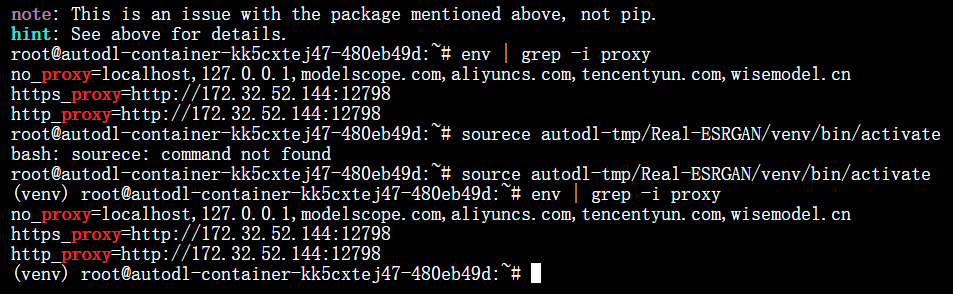
实验又验证了venv/bin/activate本身不会主动清理这些代理变量,那这里其实可能是我无意中新开了一个终端的效果。
另一方面,pip install basicsr -i https://pypi.org/simple能够绕开阿里云源,但是这个-i只传给了最外层pip。setuptools后续自行启动的pip wheel cython命令里没有-i,因此子进程重新读取系统默认配置使用阿里云源,也就再次导致了pip安装失败。
WARNING
碎碎念
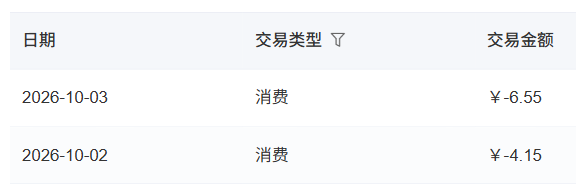
第一遍踩坑花了4块钱,第二遍复盘边跑边打王者花了6块钱,,折腾半天不如让agent自己帮我配环境了。
要是4年前买电脑的时候,舍得上个哪怕3060也好了……
欢迎点赞三连支持10块钱的成果: